
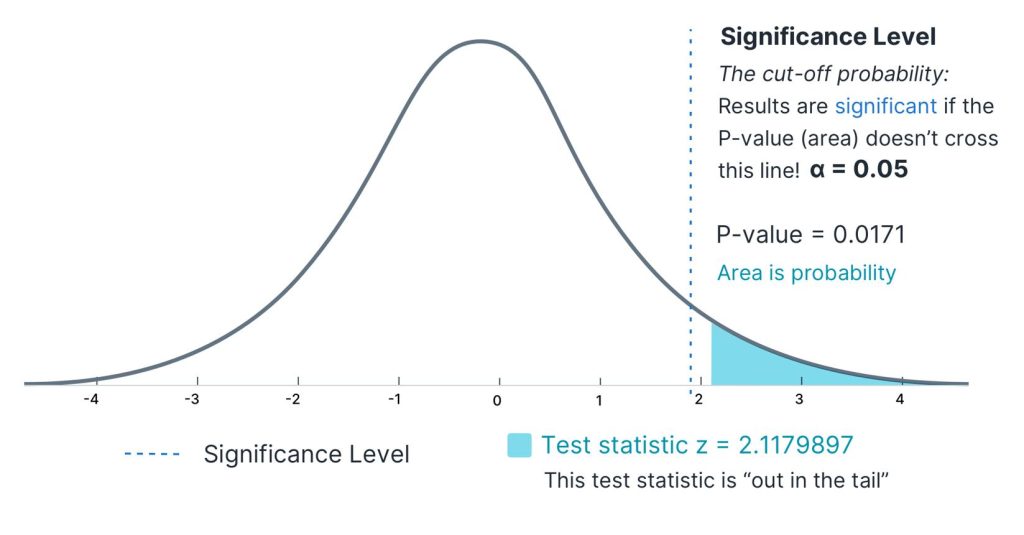
مستوى الدلالة الإحصائية (Significance Level): المفهوم والأهمية وكيفية استخدامه في تحليل البيانات
يُعد مستوى الدلالة الإحصائية (Significance Level) من أهم المفاهيم التي يحتاج الباحثون إلى فهمها عند إجراء التحليلات الإحصائية واختبار الفرضيات في الأبحاث العلمية ورسائل الماجستير والدكتوراه. فمن خلاله يستطيع الباحث تحديد المعيار الذي سيعتمد عليه لاتخاذ قرار إحصائي بشأن رفض الفرضية الصفرية أو عدم رفضها.
ويُستخدم مستوى الدلالة في العديد من الاختبارات الإحصائية، مثل اختبار T-Test وتحليل التباين ANOVA واختبار كاي تربيع Chi-Square وتحليل الانحدار، وغيرها من الأساليب التي تساعد الباحث على تحليل البيانات والوصول إلى نتائج علمية دقيقة.
ولكن ما المقصود بمستوى الدلالة؟ وما الفرق بينه وبين القيمة الاحتمالية P-Value؟ وكيف يختار الباحث مستوى الدلالة المناسب لدراسته؟
في هذا المقال، تقدم Stat Academy شرحًا مبسطًا ومتكاملًا لمفهوم مستوى الدلالة الإحصائية، مع توضيح أنواعه وأهميته وأمثلة عملية على استخدامه في الأبحاث العلمية.
ما هو مستوى الدلالة الإحصائية (Significance Level)؟
مستوى الدلالة الإحصائية هو الحد الأقصى المقبول لاحتمالية ارتكاب خطأ من النوع الأول (Type I Error)، والذي يحدث عندما يرفض الباحث الفرضية الصفرية رغم أنها صحيحة في الواقع.
ويُرمز إلى مستوى الدلالة بالرمز اليوناني (α)، ويحدده الباحث قبل إجراء الاختبار الإحصائي.
ومن أشهر مستويات الدلالة المستخدمة في الأبحاث العلمية:
-
0.05 (5%): وهو المستوى الأكثر شيوعًا في كثير من الدراسات.
-
0.01 (1%): يُستخدم عندما يرغب الباحث في اعتماد معيار أكثر صرامة لرفض الفرضية الصفرية.
-
0.10 (10%): قد يُستخدم في بعض الدراسات الاستكشافية أو المجالات التي تسمح بذلك منهجيًا.
على سبيل المثال، عندما يختار الباحث مستوى دلالة 0.05، فإنه يقبل باحتمالية تبلغ 5% لارتكاب خطأ من النوع الأول عند إجراء الاختبار وفق افتراضات النموذج الإحصائي.
ومن المهم فهم أن مستوى الدلالة لا يمثل احتمال أن تكون الفرضية الصفرية صحيحة أو خاطئة، وإنما يمثل معيارًا لاتخاذ القرار الإحصائي.
ما أهمية مستوى الدلالة في البحث العلمي؟
يمثل مستوى الدلالة عنصرًا أساسيًا في اختبار الفرضيات الإحصائية، لأنه يساعد الباحث على تحديد ما إذا كانت النتائج التي توصل إليها توفر أدلة إحصائية كافية ضد الفرضية الصفرية.
وتظهر أهميته في عدة جوانب:
1. اتخاذ القرارات الإحصائية
يساعد مستوى الدلالة الباحث على تحديد ما إذا كانت قيمة الدلالة الناتجة عن الاختبار الإحصائي تسمح برفض الفرضية الصفرية أم لا.
2. تقليل احتمالية الخطأ من النوع الأول
يتيح تحديد مستوى الدلالة مسبقًا التحكم في الحد الأقصى المقبول لاحتمالية رفض فرضية صفرية صحيحة، وفق شروط الاختبار.
3. تفسير نتائج الاختبارات الإحصائية
يساعد الباحث على تفسير قيمة P-Value ومقارنتها بالحد الذي حدده قبل إجراء التحليل.
4. دعم موثوقية النتائج البحثية
يساهم الاستخدام الصحيح لمستوى الدلالة في تعزيز جودة الاستدلال الإحصائي، خاصةً عند اختيار الاختبارات المناسبة لطبيعة البيانات.
5. اختبار الفرضيات العلمية
يُستخدم في مختلف التخصصات العلمية، مثل العلوم الطبية والتربوية والإدارية والنفسية والاجتماعية، لتقييم الأدلة المتعلقة بفرضيات البحث.
ما أشهر مستويات الدلالة الإحصائية؟
تختلف مستويات الدلالة وفقًا لطبيعة الدراسة والتخصص العلمي ومدى خطورة القرارات الناتجة عن التحليل الإحصائي.
ويوضح الجدول التالي أشهر مستويات الدلالة:
| مستوى الدلالة | النسبة المئوية | الاستخدام |
|---|---|---|
| 0.10 | 10% | بعض الدراسات الاستكشافية |
| 0.05 | 5% | المستوى الشائع في الأبحاث |
| 0.01 | 1% | معيار أكثر صرامة |
| 0.001 | 0.1% | معيار شديد الصرامة في بعض الدراسات |
هل مستوى الدلالة 0.01 أفضل من 0.05؟
ليس بالضرورة، فاختيار مستوى دلالة أقل لا يعني دائمًا أن الدراسة أفضل، ولكنه يجعل معيار رفض الفرضية الصفرية أكثر صرامة.
فعندما ينخفض مستوى الدلالة، تقل احتمالية الخطأ من النوع الأول، لكن قد تزداد احتمالية الخطأ من النوع الثاني (Type II Error) إذا لم يتغير حجم العينة وحجم التأثير وباقي ظروف الدراسة.
لذلك، يجب اختيار مستوى الدلالة بناءً على طبيعة البحث وأهدافه والمنهجية العلمية، وليس لمجرد الحصول على نتائج تبدو أكثر قوة.
ما الفرق بين مستوى الدلالة (Significance Level) والقيمة الاحتمالية (P-Value)؟
يخلط كثير من الباحثين بين مستوى الدلالة والقيمة الاحتمالية، رغم وجود اختلاف مهم بين المفهومين.
مستوى الدلالة (Significance Level):
هو الحد الذي يحدده الباحث مسبقًا لاتخاذ القرار الإحصائي، ويرمز له بـ (α).
القيمة الاحتمالية (P-Value):
قيمة P-Value هي احتمال الحصول على نتيجة مساوية أو أكثر تطرفًا من النتيجة التي ظهرت في الدراسة، بافتراض صحة الفرضية الصفرية وصحة النموذج الإحصائي المستخدم.
ويمكن توضيح الفرق بينهما من خلال المثال التالي:
إذا حدد الباحث مستوى الدلالة عند 0.05، وأجرى اختبارًا إحصائيًا وكانت قيمة P-Value الناتجة تساوي 0.03، فإن:
وبما أن:
فإن النتيجة تُعد ذات دلالة إحصائية عند مستوى 0.05، ويكون لدى الباحث دليل إحصائي كافٍ لرفض الفرضية الصفرية، وفقًا لشروط الاختبار.
أما إذا كانت قيمة P-Value تساوي 0.08، فإن:
وبالتالي لا يرفض الباحث الفرضية الصفرية عند مستوى الدلالة المحدد.
ملحوظة مهمة: عدم رفض الفرضية الصفرية لا يعني إثبات صحتها، وإنما يعني أن الأدلة المتاحة لا تكفي لرفضها عند مستوى الدلالة المختار.
كيفية تحديد مستوى الدلالة الإحصائية في البحث العلمي؟
يجب على الباحث اختيار مستوى الدلالة قبل إجراء الاختبارات الإحصائية، مع مراعاة طبيعة الدراسة والأهداف البحثية والتخصص العلمي.
وهناك مجموعة من العوامل التي تساعد في تحديد المستوى المناسب:
1. طبيعة البحث العلمي
تختلف متطلبات الدراسات الاستكشافية عن الدراسات التأكيدية، وقد تتطلب بعض الدراسات معايير أكثر صرامة من غيرها.
2. المجال العلمي للدراسة
تستخدم العديد من الأبحاث في العلوم الاجتماعية والتربوية مستوى 0.05، بينما قد تتطلب بعض الدراسات الطبية والتجارب ذات القرارات عالية المخاطر مستويات أكثر صرامة.
3. حجم العينة
لا يحدد حجم العينة مستوى الدلالة بمفرده، لكنه يؤثر في القوة الإحصائية وقدرة الاختبار على اكتشاف التأثيرات الحقيقية.
4. تكلفة الأخطاء الإحصائية
إذا كان رفض فرضية صحيحة قد يؤدي إلى قرارات خطيرة، فقد يكون من المناسب اختيار مستوى دلالة أكثر صرامة.
5. تعدد الاختبارات الإحصائية
عندما يجري الباحث عددًا كبيرًا من الاختبارات، قد ترتفع احتمالية الحصول على نتائج إيجابية كاذبة، ولذلك قد يحتاج إلى استخدام أساليب تصحيح تعدد المقارنات مثل Bonferroni.
ما علاقة مستوى الدلالة بالأخطاء الإحصائية؟
لفهم مستوى الدلالة بصورة صحيحة، يجب التعرف على نوعين أساسيين من الأخطاء التي قد تحدث عند اختبار الفرضيات.
أولًا: الخطأ من النوع الأول (Type I Error)
يحدث عندما يرفض الباحث الفرضية الصفرية رغم أنها صحيحة في المجتمع الإحصائي.
ويُعرف هذا الخطأ أحيانًا باسم الإيجابي الكاذب (False Positive).
على سبيل المثال، إذا كانت الفرضية الصفرية تفترض عدم وجود فرق حقيقي بين مجموعتين، وأظهرت الدراسة نتيجة دالة إحصائيًا رغم عدم وجود فرق في المجتمع، فهذا يمثل خطأ من النوع الأول.
ويتحكم مستوى الدلالة (α) في الحد الأقصى لاحتمالية هذا الخطأ وفق افتراضات الاختبار.
ثانيًا: الخطأ من النوع الثاني (Type II Error)
يحدث عندما يفشل الباحث في رفض الفرضية الصفرية رغم أنها خاطئة في الواقع.
ويُعرف هذا الخطأ باسم السلبي الكاذب (False Negative).
ويرمز لاحتمالية حدوثه بالرمز (β).
أما القوة الإحصائية (Statistical Power) فهي احتمال اكتشاف تأثير حقيقي عندما يكون موجودًا، وتساوي:
ويجب على الباحث الموازنة بين مستوى الدلالة والقوة الإحصائية عند تصميم الدراسة، مع الاهتمام بحجم العينة وحجم التأثير المتوقع.
كيف يتم استخدام مستوى الدلالة في برنامج SPSS؟
يُعد برنامج SPSS من أشهر البرامج المستخدمة في تحليل البيانات البحثية، ويعتمد عليه كثير من طلاب الماجستير والدكتوراه في إجراء الاختبارات الإحصائية وتفسير نتائجها.
وعند استخدام SPSS، لا يقوم الباحث عادةً بإدخال مستوى الدلالة في كل اختبار يدويًا، بل يحدد مستوى الدلالة الذي سيعتمد عليه في تفسير النتائج، ثم يقارن قيمة Sig. أو قيمة P-Value الناتجة بهذا المستوى.
ويمكن توضيح ذلك من خلال الخطوات التالية:
الخطوة الأولى: إدخال البيانات
يقوم الباحث بإدخال البيانات إلى برنامج SPSS، مع تحديد المتغيرات المستقلة والتابعة وطبيعة كل متغير.
الخطوة الثانية: اختيار الاختبار الإحصائي
يحدد الباحث الاختبار المناسب وفقًا لسؤال البحث وطبيعة البيانات، مثل اختبار T-Test أو ANOVA أو Chi-Square.
الخطوة الثالثة: تنفيذ التحليل
يقوم البرنامج بإجراء الاختبار الإحصائي وإظهار النتائج في جداول منظمة.
الخطوة الرابعة: قراءة قيمة Sig.
تظهر قيمة الدلالة الإحصائية في مخرجات البرنامج، وقد تُعرض باسم Sig. أو Asymp. Sig. أو Sig. (2-tailed) حسب الاختبار.
الخطوة الخامسة: مقارنة القيمة بمستوى الدلالة
إذا كانت قيمة P-Value أقل من مستوى الدلالة المحدد، تُعد النتيجة ذات دلالة إحصائية.
أما إذا كانت أكبر منه، فلا توجد أدلة كافية لرفض الفرضية الصفرية عند ذلك المستوى.
ويجب الانتباه إلى أن بعض الاختبارات، مثل اختبار Levene، لها دلالة خاصة تتعلق بتجانس التباين، ولا ينبغي الخلط بينها وبين دلالة الاختبار الأساسي.
مثال عملي على استخدام مستوى الدلالة في البحث العلمي
لنفترض أن باحثًا يجري دراسة لمعرفة ما إذا كان هناك فرق في متوسط التحصيل الدراسي بين طلاب مجموعتين تعليميتين.
وضع الباحث الفرضيتين التاليتين:
-
الفرضية الصفرية (H0): لا يوجد فرق ذو دلالة إحصائية بين متوسط التحصيل الدراسي للمجموعتين.
-
الفرضية البديلة (H1): يوجد فرق ذو دلالة إحصائية بين متوسط التحصيل الدراسي للمجموعتين.
حدد الباحث مستوى الدلالة عند 0.05، ثم استخدم اختبار T-Test لتحليل البيانات.
كانت النتائج كالتالي:
| العنصر | القيمة |
|---|---|
| مستوى الدلالة (α) | 0.05 |
| قيمة P-Value | 0.02 |
| القرار الإحصائي | رفض الفرضية الصفرية |
| النتيجة | يوجد فرق دال إحصائيًا |
بما أن قيمة P-Value تساوي 0.02، وهي أقل من مستوى الدلالة 0.05، فإن الباحث يرفض الفرضية الصفرية ويستنتج وجود فرق ذي دلالة إحصائية بين المجموعتين.
ولكن لا يمكن الاكتفاء بهذه النتيجة للقول إن الفرق مهم من الناحية العملية أو التعليمية، بل يجب أيضًا دراسة حجم التأثير وفترات الثقة ومتوسطات المجموعتين.
ما الأخطاء الشائعة عند استخدام مستوى الدلالة الإحصائية؟
يقع بعض الباحثين في أخطاء عند تفسير مستوى الدلالة أو استخدامه في تحليل البيانات، ومن أبرزها:
-
اعتبار مستوى الدلالة احتمال صحة الفرضية البديلة: وهذا غير صحيح، لأنه معيار للتحكم في خطأ النوع الأول وليس احتمال صحة الفرضية.
-
الاعتقاد بأن P-Value تساوي صفرًا: عندما يعرض البرنامج قيمة 0.000، فهذا يعني عادةً أن القيمة أقل من 0.001 وفق طريقة العرض، وليس أنها تساوي صفرًا تمامًا.
-
اعتبار النتيجة غير الدالة دليلًا على عدم وجود تأثير: عدم الدلالة الإحصائية لا يثبت عدم وجود تأثير، فقد يكون حجم العينة غير كافٍ.
-
اختيار مستوى الدلالة بعد ظهور النتائج: من الأفضل تحديد مستوى الدلالة مسبقًا لتجنب التحيز في تفسير النتائج.
-
الخلط بين الدلالة الإحصائية والأهمية العملية: قد تكون النتيجة دالة إحصائيًا، لكن حجم التأثير صغير وغير مهم عمليًا.
-
إجراء اختبارات متعددة دون مراعاة تعدد المقارنات: قد يؤدي ذلك إلى زيادة احتمالية النتائج الإيجابية الكاذبة.
وتجنب هذه الأخطاء يساعد الباحث على تقديم نتائج أكثر دقة وموضوعية في رسالته العلمية.
كيف تساعدك Stat Academy على فهم مستوى الدلالة والتحليل الإحصائي؟
وهنا يأتي دور Stat Academy في مساعدة الباحثين وطلاب الدراسات العليا على تطوير مهاراتهم في الإحصاء وتحليل البيانات.
تقدم الأكاديمية محتوى وخدمات متخصصة تساعد الباحث على فهم الأساليب الإحصائية واستخدام البرامج المناسبة لتحليل بياناته، مع الاهتمام بالتطبيقات البحثية التي يحتاج إليها خلال إعداد رسائل الماجستير والدكتوراه.
ومن أهم المجالات التي تساعدك Stat Academy على تطوير مهاراتك فيها:
-
فهم أساسيات الإحصاء الوصفي والاستدلالي.
-
تعلم اختبار الفرضيات الإحصائية.
-
فهم مستوى الدلالة وقيمة P-Value.
-
التدريب على برنامج SPSS.
-
إجراء اختبارات T-Test وANOVA وChi-Square.
-
تحليل الارتباط والانحدار الإحصائي.
-
اختبار صدق وثبات أدوات الدراسة.
-
تحليل الاستبيانات البحثية.
-
تفسير النتائج الإحصائية وكتابتها أكاديميًا.
لماذا تحتاج إلى التدريب مع Stat Academy؟
لأن الباحث الناجح لا يعتمد على البرنامج الإحصائي وحده، بل يجب أن يفهم لماذا اختار اختبارًا معينًا، وما الافتراضات التي يقوم عليها، وكيف يفسر النتائج بصورة صحيحة.
سواء كنت طالب ماجستير أو دكتوراه، أو باحثًا في العلوم التربوية أو الإدارية أو الطبية أو الاجتماعية، فإن تطوير معرفتك بالتحليل الإحصائي يساعدك على إنجاز أبحاثك بثقة وكفاءة أكبر.
مع Stat Academy، طوّر مهاراتك الإحصائية، وافهم نتائج أبحاثك، وانتقل من مجرد استخراج الأرقام إلى تفسيرها وتحليلها بطريقة علمية احترافية.
للتواصل مع الاكاديمية : 01090506617
ايميل : info@statacademy-eg.com
أسئلة شائعة حول مستوى الدلالة الإحصائية (Significance Level)
1. ماذا يعني مستوى الدلالة 0.05؟
يعني أن الباحث حدد الحد الأقصى المقبول لاحتمالية ارتكاب خطأ من النوع الأول عند 5%، وفق افتراضات الاختبار الإحصائي، ويستخدمه معيارًا لمقارنة قيمة P-Value.
2. ما الفرق بين مستوى الدلالة 0.05 و0.01؟
مستوى الدلالة 0.05 يسمح باحتمالية خطأ من النوع الأول تصل إلى 5%، بينما يسمح مستوى 0.01 باحتمالية تصل إلى 1%، ولذلك يُعد أكثر صرامة عند اتخاذ القرار الإحصائي.
3. متى تكون النتيجة ذات دلالة إحصائية؟
تكون النتيجة ذات دلالة إحصائية عندما تكون قيمة P-Value أقل من مستوى الدلالة المحدد مسبقًا، وفق الاختبار المستخدم.
4. هل قيمة Sig. في SPSS هي نفسها P-Value؟
في كثير من مخرجات الاختبارات الإحصائية، تمثل قيمة Sig. القيمة الاحتمالية P-Value، لكن يجب الانتباه إلى نوع الاختبار والجدول الذي تظهر فيه.
5. هل يمكن استخدام مستوى دلالة 0.10 في البحث العلمي؟
نعم، يمكن استخدامه في بعض الدراسات الاستكشافية أو وفق مبررات منهجية محددة، ولكن يجب توضيح سبب اختياره وعدم استخدامه لمجرد الحصول على نتائج دالة إحصائيًا.
6. هل انخفاض P-Value يعني أن حجم التأثير كبير؟
لا، فالقيمة الاحتمالية لا تقيس حجم التأثير. فقد تظهر نتيجة ذات دلالة إحصائية مع تأثير صغير، خاصةً عندما يكون حجم العينة كبيرًا.
7. هل يجب تحديد مستوى الدلالة قبل تحليل البيانات؟
نعم، يُفضل تحديد مستوى الدلالة مسبقًا ضمن خطة التحليل الإحصائي، مع توضيح المبررات العلمية لاختياره.
الخاتمة
يُعد مستوى الدلالة الإحصائية من المفاهيم الأساسية التي لا غنى عنها في تحليل البيانات واختبار الفرضيات البحثية. فهو يساعد الباحث على اتخاذ قرارات إحصائية مبنية على معايير واضحة، والتمييز بين النتائج ذات الدلالة الإحصائية والنتائج التي لا توفر أدلة كافية لرفض الفرضية الصفرية.
لكن الاستخدام الصحيح لهذا المفهوم يتطلب فهمًا أعمق للعلاقة بين مستوى الدلالة والقيمة الاحتمالية والأخطاء الإحصائية والقوة الإحصائية، إلى جانب اختيار الاختبار المناسب لطبيعة البيانات.
إذا كنت ترغب في تطوير مهاراتك في التحليل الإحصائي وإعداد رسالتك العلمية باحترافية، فإن Stat Academy توفر لك محتوى وخدمات متخصصة تساعدك على فهم الإحصاء وتطبيقه على الأبحاث العلمية.
ابدأ رحلتك في احتراف التحليل الإحصائي مع Stat Academy، واجعل فهم البيانات والنتائج نقطة قوة في بحثك العلمي.
اقرأ ايضا :
اترك تعليقاً